


نیوشا و پشته صوتی Caren AI-OS؛ دستیار صوتی سازمانی با صدای برند شما
از سازمانتان بپرسید چه خبر است و جواب را با صدا بشنوید. نیوشا تصویر زنده سازمان را بر اساس نقش شما میشناسد. مرکز تماس قصد تماسگیرنده را میفهمد و اگر بخواهید، صدای اختصاصی برندتان را روی سرور خودتان میسازید.
نیوشا؛ دستیاری که شخصیت دارد
| ظاهر | چه میکند |
|---|---|
| پیکو | ربات سهبعدی که سرش دنبال ماوس میچرخد، روی لبه پنجرهها مینشیند و دست تکان میدهد |
| ربات شناور | ربات ویدیویی سبک |
| گوی صوتی | حالت رسمیتر؛ روی لبه پنجرهها میغلتد و هنگام جابهجایی به موج صدا تبدیل میشود |
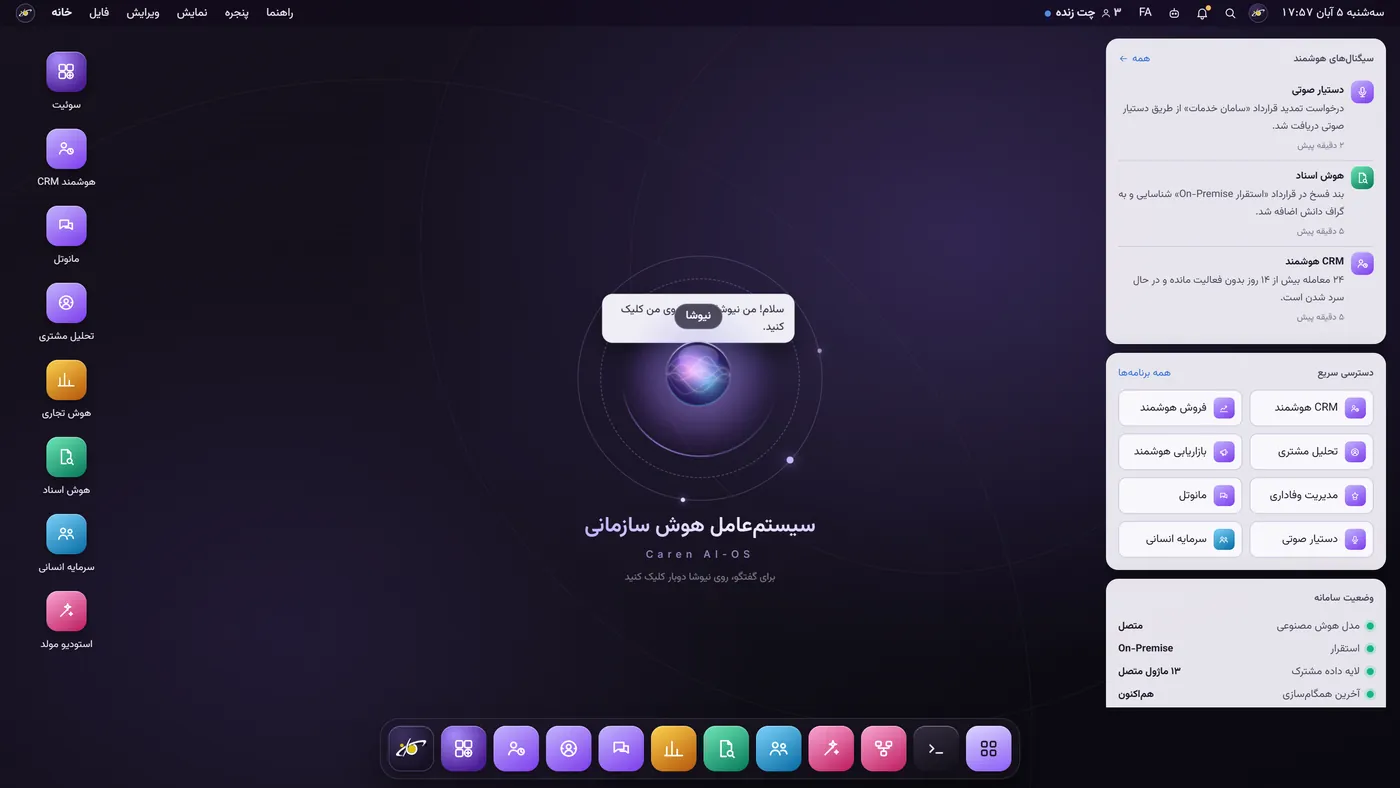
با یک گزینه در منوی «نمایش» بین آنها جابهجا میشوید. در صفحه ورود هم نیوشا خوشآمد میگوید، به پرسشهای متداول پاسخ صوتی میدهد و با گفتن «ورود» شما را به میز کار میبرد.
گفتگو با سازمان
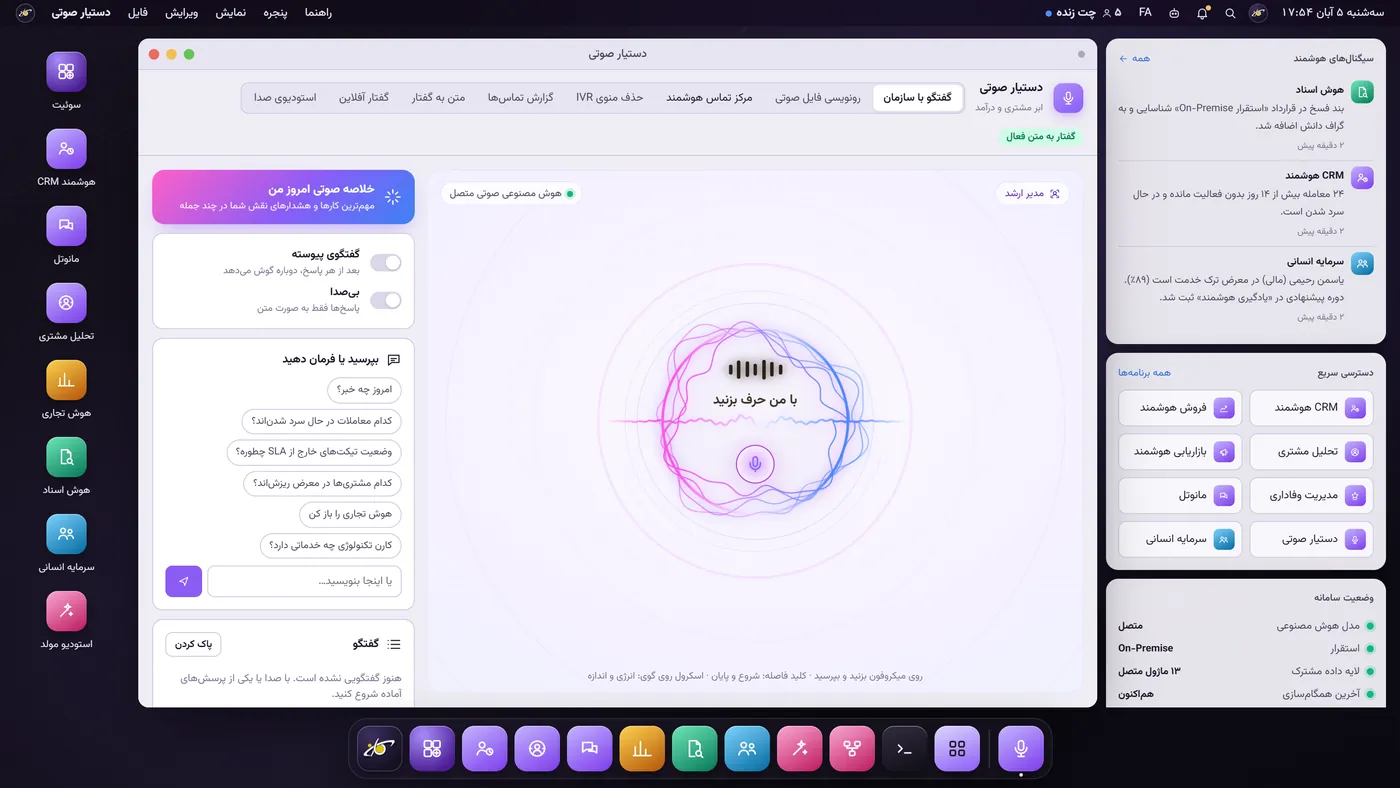
- صدای شما در مرورگر به WAV تبدیل و به متن برگردانده میشود.
- مدل زبانی پرسش را با تصویر زنده سازمان بر اساس نقش شما پاسخ میدهد.
- پاسخ با صدای گرم فارسی پخش میشود و گفتگو ادامه دارد.
«خلاصه صوتی امروز من» با یک جمله آماده است. دستورهای صوتی مانند باز کردن ماژول یا تغییر نقش هم محلی و بدون نیاز به مدل اجرا میشوند.
مرکز تماس هوشمند
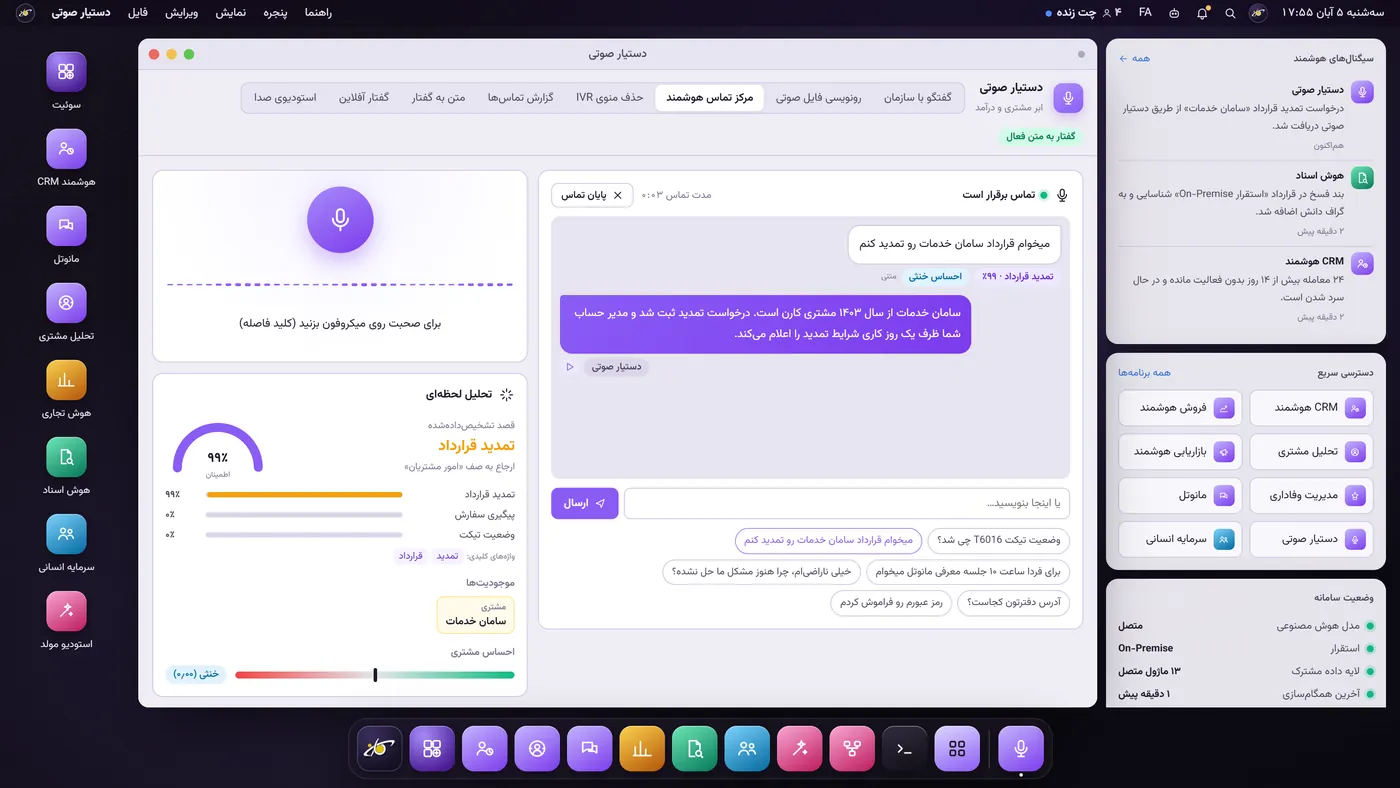
- ۱۰ قصد: پیگیری سفارش، وضعیت تیکت، تمدید قرارداد، جلسه معرفی، شکایت، اپراتور، ساعات کاری، آدرس، صورتحساب و رمز عبور.
- موجودیتها: شماره تیکت و سفارش، موبایل، تاریخ شمسی و نسبی، ساعت، مبلغ، نام و محصول.
- عدد گفتاری فارسی: «شش هزار و سه» به ۶۰۰۳ تبدیل میشود.
- حالت پاسخ هوشمند: مدل زبانی پاسخ را طبیعیتر میکند، بدون تغییر واقعیتها.
- ثبت: تیکت و هشدار در مانوتل و CRM.
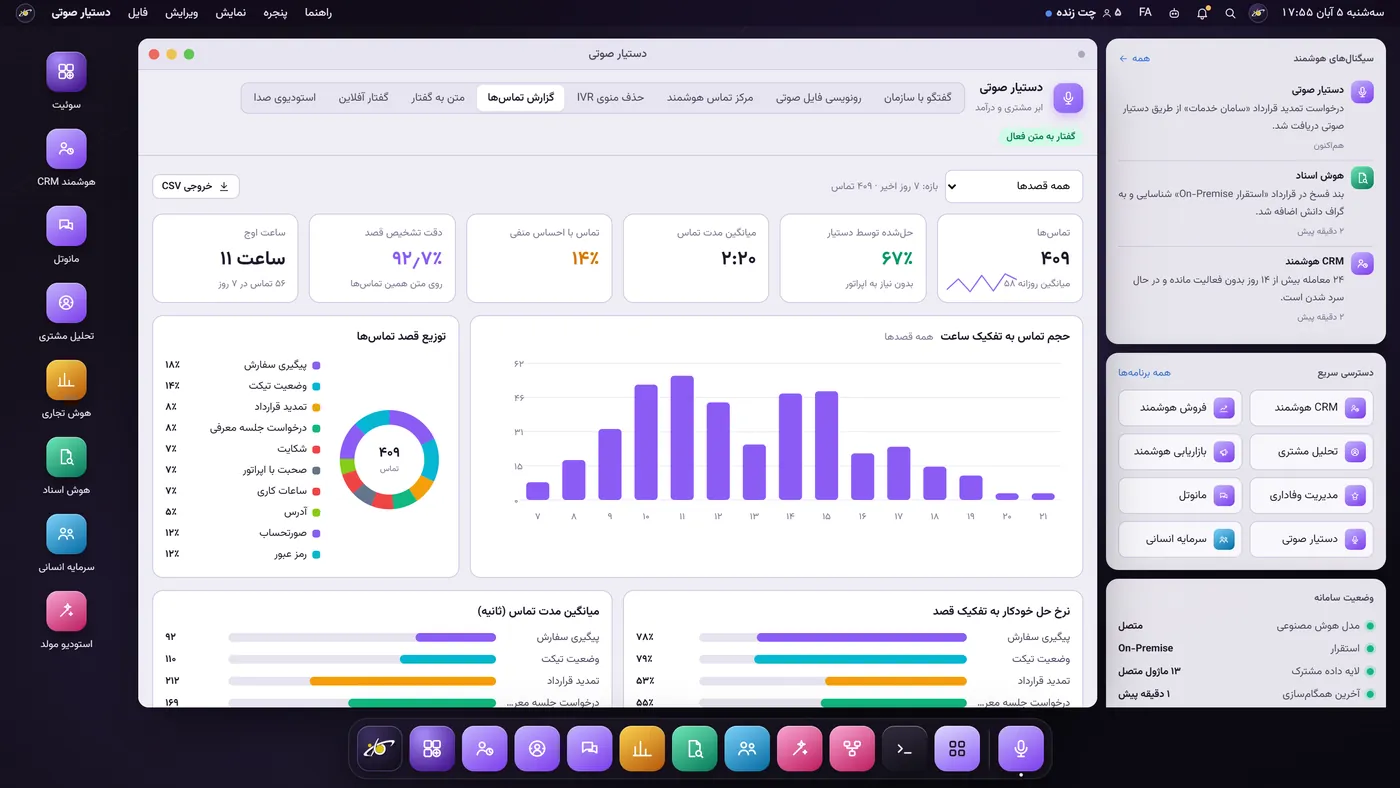
حذف منوی IVR
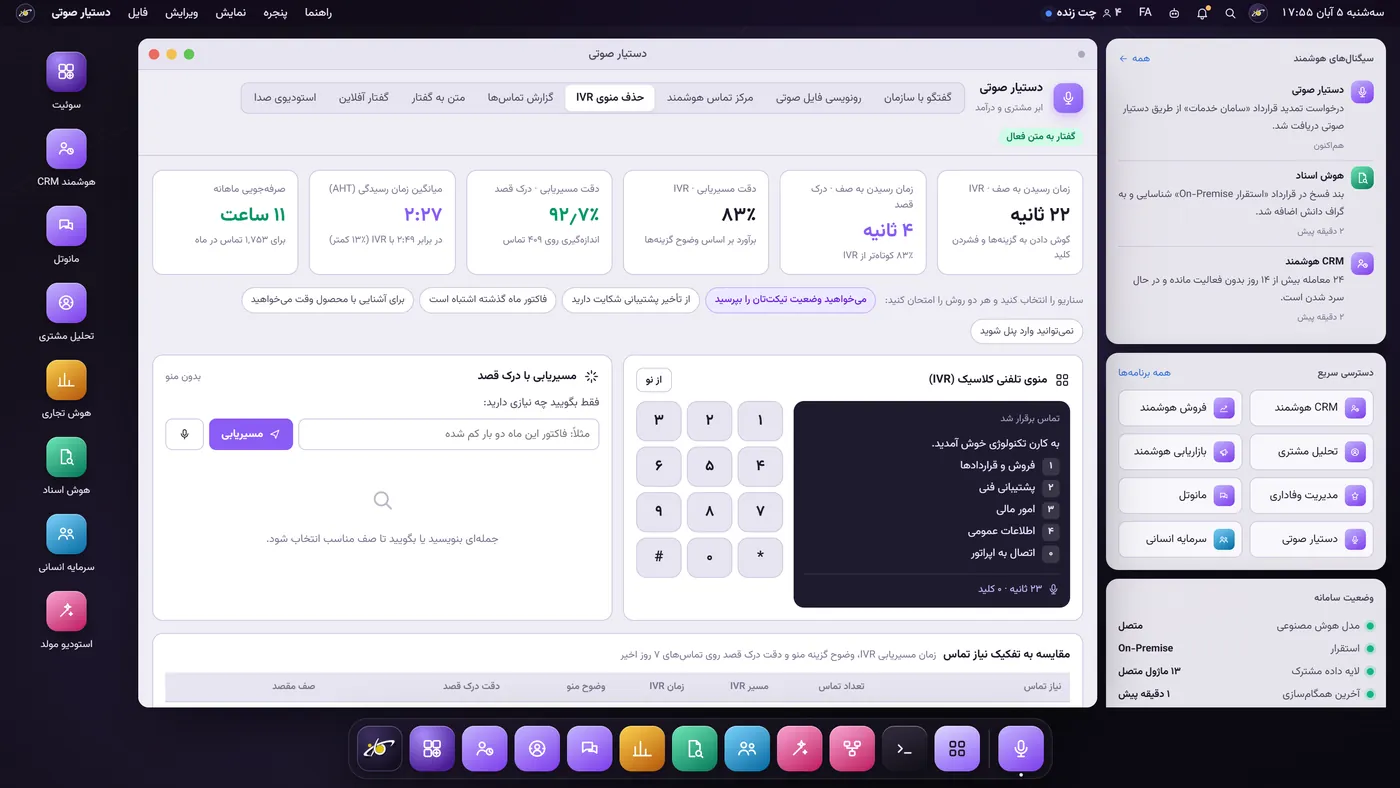
تماسگیرنده حوصله شنیدن پنج گزینه را ندارد. اینجا حرفش را میزند و تماس بر اساس قصد او مسیریابی میشود. این صفحه زمان و دقت منوی سنتی را با مسیریابی بر اساس قصد کنار هم میگذارد تا با فرضهای سازمان خودتان تصمیم بگیرید.
رونویسی فایل صوتی طولانی
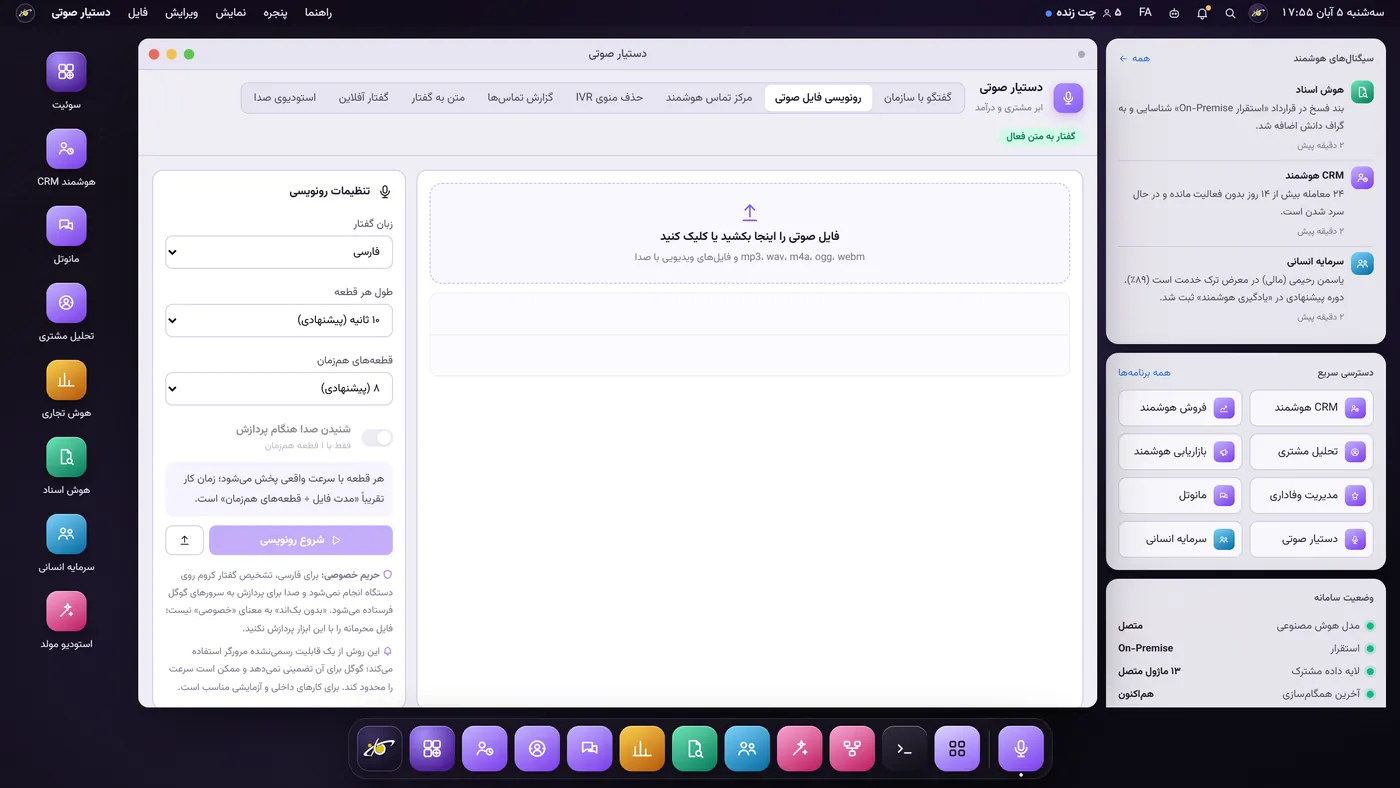
فایل طولانی با برش در سکوت به تکههای ۱۰ ثانیهای تقسیم میشود و ۸ خط موازی تشخیص گفتار مرورگر آن را پردازش میکنند. خروجی متن ساده، متن با زمان یا زیرنویس SRT است. این روش از سرویس تشخیص گفتار مرورگر استفاده میکند؛ اگر متن نباید بیرون برود، از گزینههای محلی استودیوی صدا استفاده کنید.
گفتار فارسی آفلاین
Piper (ONNX) کاملاً روی سرور سازمان اجرا میشود و هیچ متنی از سازمان خارج نمیشود. فقط دانلود اولیه مدلها اینترنت میخواهد.
- نرمالسازی فارسی: اعداد به حروف و یکسانسازی ی و ک عربی.
- چند صدای فارسی با کنترل سرعت و مکث.
- در کنار آن، متن به گفتار مرورگر با کنترل سرعت، زیر و بمی و برجستهسازی واژهها.
استودیوی صدا؛ صدای برند شما
ParsVoice-XTTS بر پایه معماری Coqui XTTS-v2 روی سرور سازمان اجرا میشود:
- شبیهسازی صدا از نمونه ۶ تا ۱۵ ثانیهای، با کنترلهای نمونهگیری.
- ساخت دیتاست از فایلهای صوتی یا ویدیویی طولانی با faster-whisper: برش خودکار ۱ تا ۱۱ ثانیهای، بازبینی و اعتبارسنجی. یا ضبط با ۶۰ جمله آماده.
- آموزش مدل صدای اختصاصی روی سرور یا دفترچه Colab، و نصب مدل آموزشدیده.
این کار به RAM زیاد و ترجیحاً GPU نیاز دارد و برای ساخت «صدای برند» سازمان است.


