


کشف خودکار بینش با z-score: ماههای غیرعادی را پیدا کنید
فروش هر ماه بالا و پایین میشود و بیشتر این نوسانها معنای خاصی ندارند. مشکل اینجاست که با چشم نمیشود فهمید کدام تغییر واقعاً مهم است. تشخیص ناهنجاری در داده فروش همین کار را با حساب انجام میدهد و سادهترین ابزارش z-score است. در این مقاله z-score را روی یک مثال فرضی گامبهگام حساب میکنیم، دام روند و فصلی بودن را میبینیم و میگوییم بعد از پیدا کردن یک ماه غیرعادی باید چه کرد.
محصول آماده کارن تکنولوژی
این را روی داده واقعی کسبوکار خودتان ببینید
آنچه در این مقاله میخوانید، در محصولات کارن پیادهسازی شده است. در جلسه دمو، همان را روی داده و فرآیند خودتان اجرا میکنیم.
درخواست دمو رایگان یا تماس بگیرید: ۰۲۱-۸۸۶۱۴۲۸۲در این صفحه
چرا با چشم نمیشود ناهنجاری را پیدا کرد
نمودار فروش ۲۴ ماه را جلوی چند مدیر بگذارید. هر کدام روی یک نقطه انگشت میگذارد. یکی به آخرین افت نگاه میکند، چون تازه است. دیگری به ماهی که با یک خاطره خاص گره خورده است. در سازمان بزرگ مسئله سختتر میشود: با چند شهر و چند محصول، صدها نمودار دارید و کسی همه را نگاه نمیکند.
ناهنجاری یعنی مقداری که با الگوی معمول داده نمیخواند. برای اینکه بگوییم چیزی غیرعادی است، اول باید بدانیم عادی چقدر است و نوسان معمول چه اندازه است. همین دو عدد پایه z-score را میسازند.
z-score چیست
z-score میگوید یک مقدار چند برابر انحراف معیار از میانگین فاصله دارد. فرمولش ساده است:
انحراف معیار اندازه نوسان معمول داده است. پس z-score فاصله را با خطکش خود همان داده اندازه میگیرد. فاصله ۱۰ واحد از میانگین در دادهای با نوسان زیاد عادی است، ولی در دادهای آرام خیلی غیرعادی است.
علامت هم معنا دارد. z مثبت یعنی بالاتر از میانگین و z منفی یعنی پایینتر. z نزدیک صفر یعنی ماهی کاملاً معمولی.
یک مثال فرضی، گامبهگام
فروش ۱۲ ماه یک شرکت فرضی، بر حسب میلیارد تومان، این است:
| ماه (فرضی) | ۱ | ۲ | ۳ | ۴ | ۵ | ۶ | ۷ | ۸ | ۹ | ۱۰ | ۱۱ | ۱۲ |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| فروش | ۱۸ | ۱۹ | ۲۰ | ۲۱ | ۱۹ | ۱۸ | ۲۰ | ۱۹ | ۳۲ | ۱۸ | ۱۹ | ۱۷ |
- میانگین: جمع این ۱۲ عدد ۲۴۰ است. ۲۴۰ تقسیم بر ۱۲ میشود ۲۰.
- مجموع مربع فاصلهها: فاصله هر ماه از ۲۰ را به توان ۲ میرسانیم و جمع میکنیم. نتیجه ۱۷۰ است. سهم ماه نهم بهتنهایی ۱۴۴ است.
- انحراف معیار: ۱۷۰ را بر ۱۱ تقسیم میکنیم، یعنی تعداد ماهها منهای یک، و میشود حدود ۱۵.۴۵. جذر آن حدود ۳.۹۳ است.
- z ماه نهم: (۳۲ - ۲۰) ÷ ۳.۹۳ که حدود ۳.۰۵ میشود.
- z ماه دوازدهم: (۱۷ - ۲۰) ÷ ۳.۹۳ که حدود منفی ۰.۷۶ میشود.
ماه دوازدهم کمترین فروش سال را دارد و شاید مدیری را نگران کند. ولی z آن نشان میدهد این افت در محدوده نوسان معمول است. ماه نهم داستان دیگری دارد و باید بررسی شود.
چه آستانهای انتخاب کنیم
قاعده رایج، مرز ۲ یا ۳ است. اگر داده تقریباً توزیع نرمال داشته باشد، حدود ۹۵ درصد مقدارها در فاصله ۲ انحراف معیار و حدود ۹۹.۷ درصد در فاصله ۳ انحراف معیار قرار میگیرند. داده فروش همیشه نرمال نیست، پس این اعداد را راهنما بدانید، نه قانون.
آستانه پایین هشدار زیاد میدهد و آستانه بالا چیزهای مهم را از دست میدهد. یک نکته دیگر هم هست که کمتر گفته میشود: در داده کوتاه، z بزرگ اصلاً ممکن نیست. وقتی خود ماه غیرعادی در محاسبه میانگین و انحراف معیار حساب میشود، با ۱۲ ماه داده بیشترین z ممکن حدود ۳.۱۸ است. یعنی آستانه ۳ در چنین دادهای خیلی سختگیر است و خیلی چیزها را نمیگیرد. برای داده کوتاه، مرز حدود ۲ منطقیتر است.
انتخاب نهایی به هزینه دو خطا بستگی دارد: بررسی بیفایده یک هشدار در برابر از دست دادن یک اتفاق مهم. این تصمیم مدیریتی است و فقط آماری نیست.
دام اول: روند
z-score ساده فرض میکند داده حول یک میانگین ثابت میچرخد. ولی فروش کسبوکار در حال رشد این طور نیست. مثال فرضی دیگری را ببینید. فروشی که هر ماه یک واحد رشد میکند: ۱۰، ۱۱، ۱۲ و همین طور تا ۱۹ در ماه دهم. انتظار داریم ماه یازدهم ۲۰ باشد، ولی ۱۵ است. ماه دوازدهم دوباره ۲۱ میشود.
z-score ساده این افت را نمیبیند. میانگین این ۱۲ ماه حدود ۱۵.۰۸ است، پس عدد ۱۵ درست نزدیک میانگین میافتد و z آن حدود منفی ۰.۰۳ است. یعنی «کاملاً عادی». در حالی که این ماه افت تندی داشته است.
راه درست این است که اول خط روند را از داده کم کنیم و z را روی باقیمانده حساب کنیم. در این مثال با برازش خط روند، فاصله ماه یازدهم از خط حدود منفی ۳.۹ است و انحراف معیار باقیماندهها حدود ۱.۳۹. پس z حدود منفی ۲.۸ میشود و این ماه بهدرستی غیرعادی شناخته میشود.
دام دوم: فصلی بودن
در بازار ایران، فروش خیلی از کسبوکارها در ماههای پایانی سال و پیش از نوروز بالا میرود و بعد از آن افت میکند. اگر این الگو را در نظر نگیرید، سامانه هر سال همان ماهها را «غیرعادی» اعلام میکند و همه کمکم به هشدارها بیاعتنا میشوند.
راه ساده، مقایسه هر ماه با همان ماه در سالهای قبل است. راه دقیقتر، جدا کردن روند و فصلی بودن از داده و بررسی باقیمانده است. هر دو به سابقه کافی نیاز دارند. با یک سال داده نمیشود فصلی بودن را از یک اتفاق تصادفی جدا کرد. منطق جدا کردن این الگوها را در پیشبینی تقاضای شعبه هم میبینید.
دام سوم: داده پرت خودش معیار را خراب میکند
به مثال اول برگردیم. ماه نهم بهتنهایی ۱۴۴ از ۱۷۰ را ساخته بود. یعنی همان ماه غیرعادی، انحراف معیار را بزرگ کرده و خودش را کمتر غیرعادی نشان داده است. اگر چند ماه غیرعادی داشته باشید، این اثر بیشتر میشود و گاهی یکدیگر را پنهان میکنند.
یک جایگزین، استفاده از میانه بهجای میانگین و MAD، یعنی میانه فاصله از میانه، بهجای انحراف معیار است. این دو کمتر تحت تأثیر داده پرت قرار میگیرند. برای شروع، z-score کافی است، به شرطی که این محدودیت را بدانید.
دام چهارم: هشدارهای تصادفی در داده زیاد
تا اینجا یک نمودار داشتیم. کشف خودکار روی صدها نمودار اجرا میشود و این حساب را عوض میکند. یک محاسبه فرضی: ۲۰ شهر ضرب در ۱۰ محصول میشود ۲۰۰ سری. هر کدام ۱۲ ماه دارد، پس ۲٬۴۰۰ نقطه داریم. اگر داده نرمال باشد و هیچ اتفاق خاصی نیفتاده باشد، حدود ۵ درصد نقطهها باز هم بیرون از مرز ۲ قرار میگیرند. یعنی حدود ۱۲۰ هشدار کاملاً تصادفی.
پس هر چه بیشتر بگردید، بیشتر هم «پیدا» میکنید. برای کم کردن این خطر، آستانه را در سطحهای خرد سختتر کنید. سریهای کوچک را که با یک سفارش جابهجا میشوند جدا کنید. بینشها را هم بر اساس اندازه اثر مرتب کنید، نه فقط z. جهشی بزرگ در محصولی که سهم کمی از فروش دارد، معمولاً از تغییر کوچکتری در محصول اصلی کماهمیتتر است.
بعد از پیدا کردن ماه غیرعادی چه کنیم
z-score میگوید کجا را نگاه کنید، نه اینکه چرا. برای علت، این پرسشها را به ترتیب بپرسید:
- داده درست است؟ خطای ثبت، فاکتور تکراری یا تغییر تعریف، رایجترین علت ناهنجاریاند.
- کجا رخ داده است؟ داده را بر اساس شهر، محصول و مشتری خرد کنید. شاید یک قرارداد بزرگ کل عدد را بالا برده باشد.
- چه چیزی همان موقع عوض شد؟ کمپین، قیمت، موجودی یا اتفاق بیرونی.
- تکرارپذیر است؟ اگر علت مثبت بود، میشود آن را تکرار کرد؟ اگر منفی بود، چطور میشود جلویش را گرفت؟
توضیح متنی هر بینش را میشود به هوش مصنوعی سپرد، به شرطی که عدد از محاسبه سامانه بیاید. این مرز را در چرا هوش مصنوعی نباید عدد بسازد توضیح دادهایم. برای رساندن نتیجه به مدیران هم گزارش مدیریتی خودکار را ببینید.
نمونه عملی: Caren AI-OS
برای دیدن این روش در یک محصول، پلتفرم هوش تجاری را در Caren AI-OS، محصولی از کارن تکنولوژی، مثال میزنیم. تب «کشف بینش» بهجای آنکه منتظر پرسش شما بماند، خودش در داده میگردد و این موارد را پیدا میکند: سریعترین و کندترین رشد، تغییر ترکیب محصول، ماههای غیرعادی با z-score، حاشیههای غیرعادی و اوج و فرود فصلی.
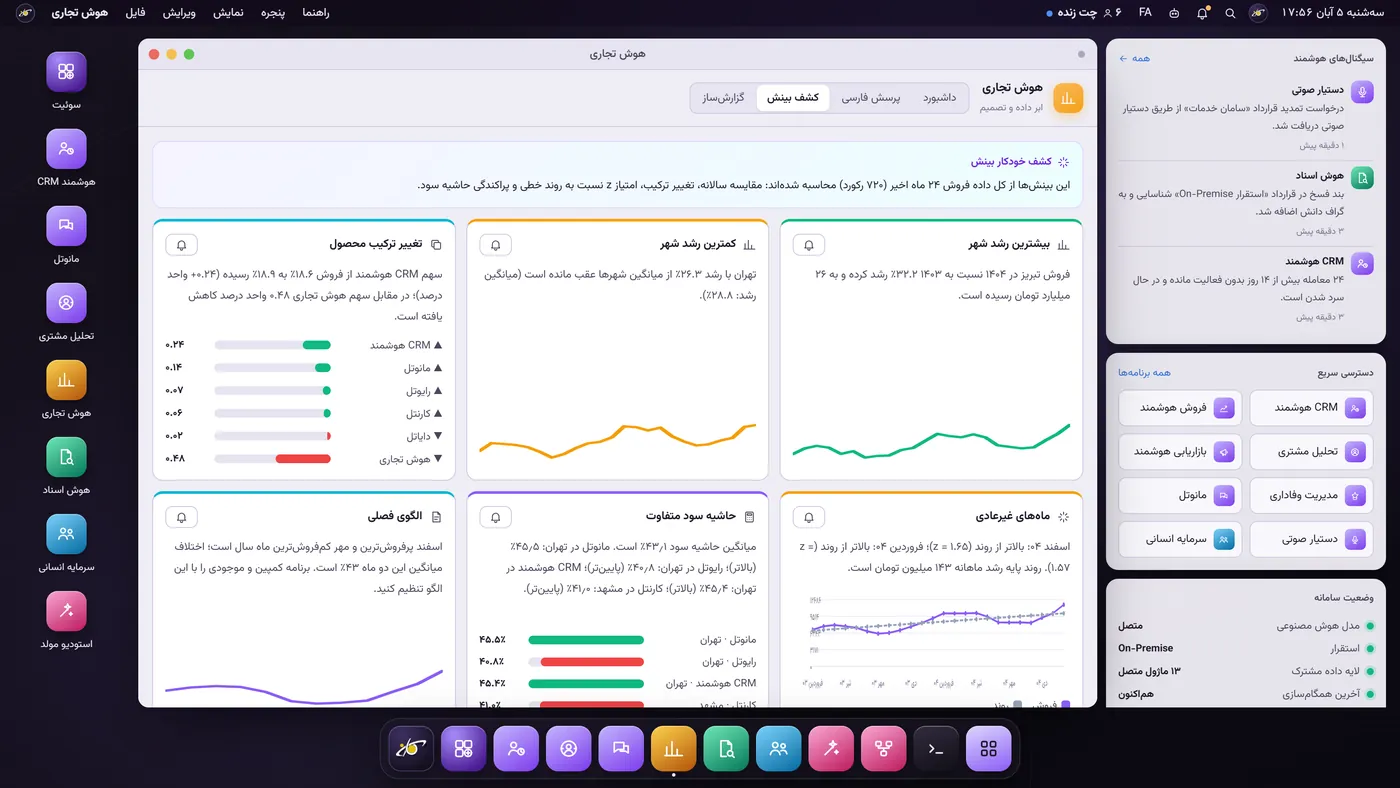
هر بینش را میتوان به فید سیگنالهای میز کار فرستاد تا مدیران دیگر هم آن را ببینند. برای پیگیری علت هم در همان پلتفرم میتوانید از داده به فارسی بپرسید و عدد و نمودار بگیرید. داشبورد تعاملی هم با کلیک روی هر شهر، همه نمودارها را فیلتر میکند.
این تحلیلها در مرورگر اجرا میشوند. روشهای پشت آنها در معماری و امنیت Caren AI-OS آمده است. قیمت Caren AI-OS بسته به ابعاد سازمان، پلتفرمهای متصل و مدل استقرار تعیین میشود.
ببینید داده فروش شما چه چیزی را پنهان کرده است
در یک جلسه معرفی، کشف خودکار بینش و پرسش فارسی از داده را با داده نمونه مرور میکنیم.
پرسشهای متداول
بله. با تابع AVERAGE میانگین و با STDEV.S انحراف معیار را بگیرید و فاصله هر ماه از میانگین را بر آن تقسیم کنید. تابع STANDARDIZE هم همین کار را میکند. برای چند سری محدود، اکسل کافی است. مشکل از جایی شروع میشود که تعداد شهر و محصول زیاد باشد.
عدد قطعی وجود ندارد، ولی با چند ماه کم، میانگین و انحراف معیار قابل اعتماد نیستند. دوازده ماه برای شروع منطقی است و برای جدا کردن فصلی بودن معمولاً به دو سال یا بیشتر نیاز دارید. هر چه داده کمتر باشد، نتیجه را با احتیاط بیشتری بخوانید.
بله، و شاید بیشتر. ماهی که فروش غیرعادی بالا بوده میتواند یک فرصت تکرارپذیر را نشان دهد. شاید هم نشانه یک خطای ثبت باشد. بیشتر تیمها فقط افت را بررسی میکنند و خیلی از درسهای مفید اوجها را از دست میدهند.
نه بهتنهایی. z-score ماه یا تراکنش غیرعادی را نشان میدهد، ولی تقلب حرفهای معمولاً طوری طراحی میشود که غیرعادی به نظر نرسد. میتوانید از این روش بهعنوان یک سیگنال اولیه استفاده کنید، ولی به قواعد کسبوکار و بررسی انسانی هم نیاز دارید.
حذف نکنید، جدا برچسب بزنید. این ماهها واقعیاند و برای برنامهریزی مهماند. اگر اثر آنها در مدل عادی محسوب شود، ناهنجاری واقعی همان دوره هم دیده میشود. مقایسه هر جشنواره با جشنواره مشابه سال قبل تصویر درستتری میدهد.
بله، ولی داده روزانه الگوی هفتگی دارد. مثلاً پنجشنبه و جمعه با روزهای دیگر فرق دارند. هر روز را با همان روز هفتههای قبل مقایسه کنید. داده روزانه نویز بیشتری هم دارد، پس آستانه و تعداد هشدارها را با دقت تنظیم کنید.
عدد ثابتی وجود ندارد. اگر هشدارها نادیده گرفته میشوند، زیادند. آستانه را طوری تنظیم کنید که هر هشدار ارزش چند دقیقه بررسی را داشته باشد. نگه داشتن نتیجه بررسی هر هشدار هم کمک میکند بفهمید کدام نوع از آنها واقعاً مفید بوده است.


