


رتبهبندی کاندیداها با هوش مصنوعی بدون جعبه سیاه: فرمول ۵۰/۳۵/۱۵
وقتی برای یک موقعیت رزومههای زیادی میرسد، کسی نمیتواند همه را با دقت یکسان بخواند. رتبهبندی کاندیدا با هوش مصنوعی وسوسهکننده است، ولی یک عدد بیدلیل میتواند آدم مناسب را بیسروصدا حذف کند. در این مقاله میبینید جعبه سیاه در استخدام چه خطری دارد، هر نشانه چه چیزی را میبیند و نمیبیند و یک امتیاز ترکیبی قابل توضیح با فرمول ۵۰/۳۵/۱۵ چطور ساخته میشود.
محصول آماده کارن تکنولوژی
این را روی داده واقعی کسبوکار خودتان ببینید
آنچه در این مقاله میخوانید، در محصولات کارن پیادهسازی شده است. در جلسه دمو، همان را روی داده و فرآیند خودتان اجرا میکنیم.
درخواست دمو رایگان یا تماس بگیرید: ۰۲۱-۸۸۶۱۴۲۸۲در این صفحه
جعبه سیاه در استخدام یعنی چه
فرض کنید نرمافزار به یک کاندیدا ۴۲ و به دیگری ۸۷ داده است. میپرسید چرا؟ جوابی نیست. این جعبه سیاه است. سه مشکل دارد:
- قابل توضیح نیست: نه به مدیر استخدام میتوانید دلیل بدهید، نه به کاندیدا.
- سوگیری پنهان میماند: مدل ممکن است الگوهایی را ترجیح بدهد که به شغل ربطی ندارند. وقتی دلیل دیده نشود، این ترجیح هم دیده نمیشود.
- چیزی یاد نمیگیرید: اگر نتیجه بد شد، نمیدانید کدام بخش از سنجش خطا داشته است.
این مسئله فقط اخلاقی نیست. در بعضی کشورها هم استفاده از هوش مصنوعی در استخدام زیر قواعد سختتری قرار گرفته است. قابل توضیح بودن، عادت خوبی است که در هر حال به نفع شماست.
چرا یک نشانه کافی نیست
هر روش سنجش زاویه دید خودش را دارد و نقطه کوری هم دارد. ترکیب آنها خطای هر کدام را تا حدی جبران میکند:
| نشانه | چه چیزی را میبیند | چه چیزی را نمیبیند |
|---|---|---|
| تناسب با مدل زبانی | خواندن رزومه در برابر شرح شغل، با دلیل | رزومه خوشنوشت را بهتر میبیند |
| شباهت معنایی | نزدیکی معنای رزومه به شغل | شباهت متن، نه توانایی واقعی |
| مصاحبه | رفتار، استدلال و انگیزه | فقط برای کسانی که به این مرحله رسیدهاند وجود دارد |
پیش از رتبهبندی چه چیزی باید آماده باشد
- شرح شغل مشخص: الزامات اصلی را از «خوب است داشته باشد» جدا کنید. مدل و Embedding هر دو از همین متن میخوانند.
- متن کامل رزومه: اگر رزومه اسکن است، اول باید خوانده شود. مسیرش را در مقاله تحلیل خودکار رزومههای فارسی ببینید.
- کارت امتیاز مصاحبه: اگر مصاحبهگرها معیار یکسان نداشته باشند، عدد مصاحبه فقط سلیقه را جمع میزند.
- مسئول بازبینی: از اول معلوم باشد چه کسی دلیلها را میخواند و چه کسی تصمیم میگیرد.
نشانه اول: تناسب با مدل زبانی
در این روش، مدل زبانی رزومه را با شرح موقعیت و الزامات مقایسه میکند و امتیازی همراه با دلیل میدهد: نقاط قوت کاندیدا و شکافهای مهارتی او. ارزش واقعی در همین دلیل است. مدیر استخدام میتواند بخواند و بگوید «این شکاف برای ما مهم نیست» یا «این نقطه قوت را مدل بیش از حد جدی گرفته است».
کیفیت این امتیاز به کیفیت شرح شغل بستگی دارد. اگر الزامات مبهم باشند، امتیاز هم مبهم است. پس پیش از هر چیز، مرحله شرح شغل را جدی بگیرید.
نشانه دوم: شباهت معنایی
جستجوی کلمه کلیدی فقط متن یکسان را پیدا میکند. اگر شرح شغل از «جذب نیرو» حرف بزند و رزومه از «استخدام»، جستجوی ساده آنها را به هم وصل نمیکند.
Embedding معنای متن را به یک بردار عددی تبدیل میکند. متنهایی با معنای نزدیک، بردارهای نزدیک دارند، حتی با کلمات متفاوت. همین فناوری پشت جستجوی معنایی در RAG هم هست. فاصله دو بردار به عددی تبدیل میشود که میگوید رزومه چقدر به شغل نزدیک است.
این عدد سریع و یکنواخت است، و چون به مدل زبانی بیرونی نیاز ندارد میتواند کاملاً داخل سازمان حساب شود. ولی فقط شباهت متن را میسنجد و درباره توانایی فرد چیزی نمیگوید.
نشانه سوم: مصاحبه
مصاحبه تنها نشانهای است که مستقیماً از آدم میآید، نه از متنی که خودش نوشته است. اگر مصاحبهگرها با کارت امتیاز و معیارهای یکسان کار کنند، این عدد قابل مقایسه میشود.
مسئله این است که این نشانه دیر میرسد. در ابتدای کار، هیچ کاندیدایی مصاحبه نشده است. پس فرمول باید بتواند با نبود یک مؤلفه هم کار کند.
فرمول ۵۰/۳۵/۱۵ با یک مثال
یک ترکیب مشخص این است: ۵۰٪ تناسب AI + ۳۵٪ شباهت معنایی رزومه + ۱۵٪ مصاحبه. عددهای زیر فقط برای نشان دادن محاسبهاند و از هیچ داده واقعی نیامدهاند:
| مؤلفه | امتیاز فرضی | وزن | سهم |
|---|---|---|---|
| تناسب AI | ۸۰ | ۵۰٪ | ۴۰ |
| شباهت معنایی | ۷۰ | ۳۵٪ | ۲۴٫۵ |
| مصاحبه | ۹۰ | ۱۵٪ | ۱۳٫۵ |
| امتیاز ترکیبی | ۷۸ |
حالا فرض کنید همین کاندیدا هنوز مصاحبه نشده است. وزنها به نسبت خودشان دوباره نرمال میشوند، یعنی تناسب و شباهت روی ۸۵ سهم باقیمانده تقسیم میشوند و نتیجه حدود ۷۵٫۹ میشود. پس هیچکس فقط چون هنوز مصاحبه نشده صفر نمیگیرد.
دو کاندیدا با امتیاز تقریباً یکسان
عددهای این مثال هم فرضیاند. هیچکدام از این دو نفر هنوز مصاحبه نشدهاند، پس فقط دو مؤلفه در کار است:
| کاندیدا | تناسب AI | شباهت معنایی | امتیاز ترکیبی |
|---|---|---|---|
| نفر الف | ۹۰ | ۵۵ | حدود ۷۵٫۶ |
| نفر ب | ۷۰ | ۸۵ | حدود ۷۶٫۲ |
اگر فقط امتیاز نهایی را ببینید، این دو تقریباً برابرند و نفر ب کمی جلوتر است. ولی داستانشان فرق دارد. نفر الف به گفته مدل با الزامات شغل خوب میخواند، هرچند متن رزومهاش از نظر واژگان و زمینه فاصله دارد. شاید از صنعت دیگری میآید. نفر ب رزومهای خیلی نزدیک به شغل دارد، ولی مدل شکافهایی در الزامات دیده است.
حالا باید دلیل تناسب هر دو را بخوانید. شاید شکاف نفر ب یک ابزار کوچک است که زود یاد میگیرد. شاید هم یک الزام اصلی است. فرق کمتر از یک امتیاز این را به شما نمیگوید. برای همین اختلاف کوچک امتیاز را نباید مبنای ترتیب قطعی گرفت.
این امتیاز برای چیست و برای چه نیست
امتیاز ترکیبی برای کوتاه کردن فهرست و تعیین ترتیب خواندن است. جای تصمیم استخدام را نمیگیرد. وزن کم مصاحبه هم در این فرمول به این معنا نیست که مصاحبه بیاهمیت است. مصاحبه در مرحله تصمیم نهایی، کنار دادههای دیگر، بهطور کامل دیده میشود.
به این هم توجه کنید که چه چیزهایی در این فرمول نیستند: نمره آزمون و وزن مراحل فرایند. نتیجه آزمون را باید جداگانه و هنگام تصمیم بخوانید.
سوگیری از کجا وارد میشود
هوش مصنوعی سوگیری را از هیچ نمیسازد، ولی میتواند آن را تکرار و بزرگ کند. چند مسیر رایج این است:
- شرح شغل: اگر الزامات بیدلیل سختگیرانه باشند، مثل شرط مدرک خاص برای کاری که به آن نیاز ندارد، امتیاز هم همان را پاداش میدهد.
- الگوی متن: مدل ممکن است سبک نوشتن یا نام شرکتها و دانشگاههای آشنا را ترجیح بدهد.
- داده گذشته: اگر معیارها از روی استخدامهای قبلی ساخته شوند، ترجیحات قبلی سازمان هم منتقل میشوند.
- مصاحبه: این نشانه انسانی هم بیسوگیری نیست. کارت امتیاز و چند مصاحبهگر این خطر را کم میکنند.
قابل توضیح بودن سوگیری را از بین نمیبرد، ولی آن را دیدنی میکند. وقتی دلیل امتیاز روی صفحه است، میتوانید بگویید «این دلیل به شغل ربط ندارد». در یک عدد بیدلیل، حتی نمیفهمید باید چنین چیزی بگویید. نگاه مشابهی را در مقاله ارزیابی هوشمند اپراتور بدون بیعدالتی هم آوردهایم.
چطور از آن درست استفاده کنید
- حذف خودکار نکنید: پایین بودن امتیاز دلیلی برای خواندن یا پرسیدن است، نه حکم رد.
- نمونه پایین فهرست را بخوانید: هر چند وقت یک بار چند رزومه کمامتیاز را خودتان بخوانید. اگر آدم خوب پیدا شد، چیزی در معیارها میلنگد.
- معیارهای بیربط را کنار بگذارید: نام دانشگاه یا شکاف شغلی فقط وقتی معیار است که واقعاً به شغل ربط داشته باشد.
- رزومهنویسی را با توانایی اشتباه نگیرید: کسی که خوب مینویسد لزوماً بهتر کار نمیکند.
- نتیجه را با دوره آزمایشی مقایسه کنید: این تنها راه فهمیدن ارزش واقعی امتیاز است.
نمونه عملی: رتبهبندی در Caren Enterprise AI
رتبهبندی ترکیبی Caren Enterprise AI، محصولی از کارن تکنولوژی، از همین فرمول استفاده میکند. امتیاز تناسب از ۰ تا ۱۰۰ است و نقاط قوت و شکاف مهارتی کنارش میآید. روی آن صریحاً نوشته شده که پیشنهاد هوش مصنوعی و کمکتصمیم است و تصمیم نهایی با شماست. زیرامتیازها نمایش داده میشوند، ستاره شورتلیست و بازمحاسبه هم هست و اگر مؤلفهای نباشد وزنها دوباره نرمال میشوند.
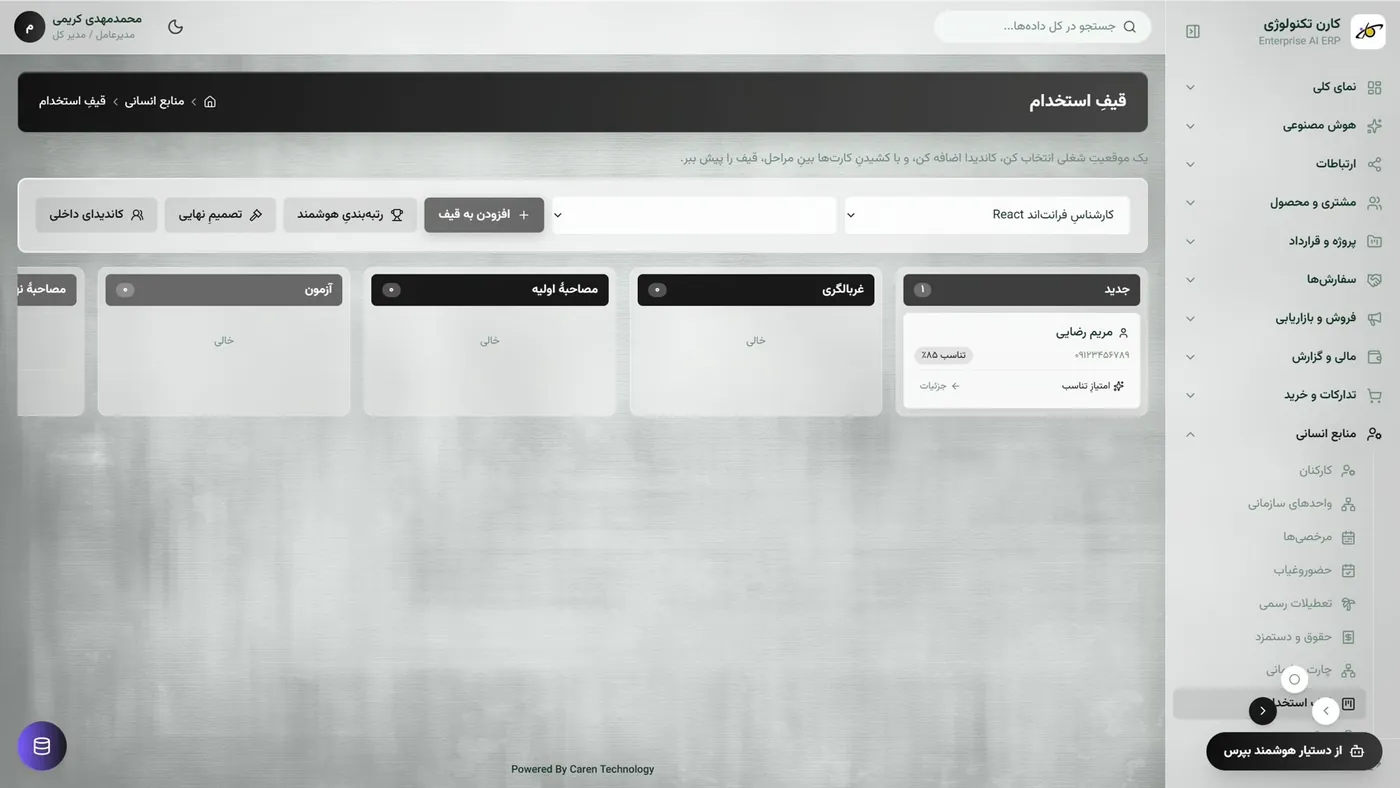
شباهت معنایی با Embedding محلی چندزبانه حساب میشود، پس رزومه برای این مؤلفه از سرور خارج نمیشود. امتیاز تناسب کار مدل زبانی است. در حالت ابری، متن لازم برای آن به ارائهدهنده مدل میرود و در استقرار محلی مدل هم روی سرور سازمان اجرا میشود. نمای کلیتر را در پلتفرم هوشمند منابع انسانی ببینید.
میخواهید دلیل هر امتیاز را ببینید؟
رتبهبندی ترکیبی Caren Enterprise AI را روی یک موقعیت شغلی در دموی زنده ببینید.
پرسشهای متداول
غربالگری خودکار بعضی کاندیداها را بدون نگاه انسان حذف میکند. رتبهبندی فقط ترتیب خواندن را پیشنهاد میدهد و همه کاندیداها در دسترس میمانند. برای همین خطر حذف بیسروصدا در آن کمتر است.
عددی که نشان میدهد معنای متن رزومه چقدر به معنای شرح شغل نزدیک است، حتی اگر کلمههای متفاوتی به کار رفته باشند. این عدد از مقایسه بردارهای عددی متنها به دست میآید و توانایی فرد را نمیسنجد.
تا حدی. وزنها دوباره نرمال میشوند تا او صفر نگیرد، ولی امتیازش فقط بر پایه رزومه است. بهتر است کاندیداهای هممرحله را با هم مقایسه کنید و تفاوتهای کوچک را تعیینکننده ندانید.
تأثیر کلمه کلیدی در سنجش معنایی کمتر از جستجوی ساده است، ولی رزومه خوشنوشت همیشه مزیتی دارد. برای همین امتیاز رزومه باید فقط نقطه شروع باشد و مصاحبه ادعاها را بسنجد.
این رتبهبندی رزومه و مصاحبه را ترکیب میکند و آزمونها جداگانه با حد نصاب خودشان بررسی میشوند. نمره آزمون را هنگام تصمیم نهایی کنار امتیاز ترکیبی ببینید و این دو را با هم اشتباه نگیرید.
چند رزومه پایین فهرست را بهطور منظم بخوانید، دلیل امتیازها را نگاه کنید و ببینید آیا گروهی از کاندیداها بدون دلیل شغلی امتیاز کمتری میگیرند. نتیجه را هم بعداً با عملکرد واقعی افراد مقایسه کنید.
برای تعیین ترتیب بررسی بله، برای حذف خودکار نه. مرز ثابت باعث میشود تفاوت بسیار کوچک امتیاز، سرنوشت یک کاندیدا را تعیین کند. اگر حد نصاب میگذارید، بررسی نمونهای پایین مرز را هم حفظ کنید.


