


تحلیل خودکار رزومههای فارسی، حتی اسکنشده
هر کسی که پوشه رزومههای یک موقعیت شغلی را باز کرده باشد، این صحنه را میشناسد: فایل Word، PDF دوستونی، اسکن کج و عکسی که با موبایل گرفته شده است. کسی باید همه اینها را بخواند و نام، شماره، مهارت و سابقه را وارد کند. تحلیل رزومه با هوش مصنوعی این کار را کوتاه میکند. در این مقاله میبینید این کار چند مرحله دارد، کجا سخت است و چرا آخرین قدم باید با انسان بماند.
محصول آماده کارن تکنولوژی
این را روی داده واقعی کسبوکار خودتان ببینید
آنچه در این مقاله میخوانید، در محصولات کارن پیادهسازی شده است. در جلسه دمو، همان را روی داده و فرآیند خودتان اجرا میکنیم.
درخواست دمو رایگان یا تماس بگیرید: ۰۲۱-۸۸۶۱۴۲۸۲در این صفحه
تحلیل رزومه دو کار متفاوت است
وقتی از تحلیل رزومه حرف میزنیم، معمولاً دو کار را با هم قاطی میکنیم:
- استخراج: چه چیزی در این رزومه نوشته شده است؟ نام، موبایل، مهارتها، سالهای سابقه.
- ارزیابی: این آدم چقدر برای این شغل مناسب است؟
این مقاله درباره استخراج است. ارزیابی موضوع دیگری است و آن را در مقاله رتبهبندی کاندیداها بدون جعبه سیاه توضیح دادهایم. جدا نگه داشتن این دو مهم است. خطای استخراج را با نگاه به فایل میشود پیدا کرد، ولی خطای ارزیابی سوگیری میسازد و سختتر دیده میشود.
قدم اول: رسیدن به متن
پیش از هر تحلیلی باید متن رزومه را داشته باشید. مسیر رسیدن به آن به نوع فایل بستگی دارد:
| نوع فایل | متن از کجا میآید | سختی اصلی |
|---|---|---|
| Word | مستقیم از فایل | جدول و کادرهای متنی |
| PDF متنی | لایه متن داخل فایل | ترتیب خواندن در چیدمان چندستونی |
| PDF اسکنشده | OCR | کیفیت اسکن و کجی صفحه |
| عکس موبایل | OCR | نور، سایه و زاویه |
نکته این است که از روی پسوند نمیشود فهمید با چه فایلی طرفید. یک PDF میتواند فقط یک عکس از صفحه باشد. پس سیستم باید خودش بررسی کند که متن قابل خواندنی در فایل هست یا نه.
بخشی از مسئله را میشود پیش از رسیدن فایل حل کرد. در صفحه فرصتهای شغلی از متقاضی بخواهید نام، موبایل و ایمیل را خودش در فرم وارد کند و رزومه را ترجیحاً بهصورت فایل اصلی بفرستد، نه عکس. این کار OCR را کنار نمیگذارد، چون همیشه کسی با رزومه کاغذی میآید و رزومههای قبلی هم در پوشهها هست. ولی اطلاعات تماس را مطمئنتر میکند.
OCR چیست و در فارسی چه سختیهایی دارد
OCR تصویر نوشته را به متن تبدیل میکند. در رزومههای فارسی چند چیز کار را سختتر میکند:
- حروف چسبیده و نقطهها: شکل هر حرف به جایش در کلمه بستگی دارد و یک نقطه پاکشده میتواند حرف را عوض کند.
- ترکیب فارسی و انگلیسی: نام ابزارها و مدرکها اغلب انگلیسی است و جهت خط وسط جمله عوض میشود.
- ارقام مختلف: ممکن است در یک رزومه ارقام فارسی و انگلیسی کنار هم باشند.
- چیدمان گرافیکی: ستونها، آیکونها و نوار مهارت. نواری که نیمهپر است برای OCR معنایی ندارد.
- کیفیت پایین: اسکن کپی از کپی، یا عکس با سایه دست.
پس خروجی OCR تقریباً همیشه کمی خطا دارد. با این خطا باید طراحی کرد، نه اینکه انتظار داشت نباشد. نمونههای دیگر این مسئله را در مقاله استخراج داده از اسناد با OCR فارسی میبینید.
قدم دوم: از متن به داده ساختاریافته
حالا متنی نامرتب داریم. باید بدانیم کدام بخش نام است و کدام مهارت. روشهای قدیمی با قواعد و الگوی ثابت کار میکردند و با هر چیدمان تازه میشکستند، چون رزومه قالب استاندارد ندارد.
مدل زبانی اینجا واقعاً مفید است. شما یک ساختار دقیق به آن میدهید و میگویید: این متن را بخوان و این فیلدها را برگردان. مدل معنا را میفهمد، پس «تلفن همراه»، «موبایل» و «شماره تماس» را یکی میبیند و سابقه شغلی را حتی بدون تیتر مشخص پیدا میکند.
«اگر نبود، حدس نزن»
خطر همان است که در مقاله چرا هوش مصنوعی نباید عدد بسازد گفتیم. مدل زبانی دوست دارد جای خالی را پر کند. اگر رزومه شماره موبایل نداشته باشد یا OCR آن را خراب کرده باشد، مدل ممکن است عددی بسازد که شبیه موبایل است. اگر سابقه کار روشن نباشد، شاید سالی حدس بزند.
این خطا از خالی ماندن فیلد بدتر است. فیلد خالی را کارشناس میبیند و پر میکند. مقدار ساختگی را شاید هرگز نبیند. پس قاعده باید صریح باشد: هر چیزی که در متن نیست، خالی بماند.
قدم سوم: نرمالسازی در سامانه
خروجی مدل را نباید مستقیم ذخیره کرد. سامانه باید آن را با قواعد قطعی بررسی کند:
- موبایل: شماره با فاصله، با پیششماره کشور یا با ارقام فارسی و عربی، به یک قالب واحد تبدیل میشود. اگر با الگوی موبایل نخواند، پذیرفته نمیشود.
- ایمیل: شکل آدرس بررسی میشود. OCR بهراحتی حرفها را در ایمیل جابهجا میکند.
- تکراریها: اگر همین فرد قبلاً رزومه فرستاده باشد، باید به پرونده قبلی وصل شود، نه اینکه کاندیدای تازه ساخته شود.
این تقسیم کار همان اصل همیشگی است: مدل برای فهمیدن و سامانه برای قاعده.
قدم چهارم: بازبینی انسان
آخرین قدم مهمترین قدم است. خروجی باید به شکل فرم پیشپر به کارشناس برسد، کنار فایل اصلی، تا او در چند لحظه بررسی و تأیید کند. کارشناس همچنان نگاه میکند، ولی بهجای تایپ کردن، بازبینی میکند.
ذخیره خودکار شاید سریعتر به نظر برسد، ولی هزینهاش را بعداً میدهید: زنگ زدن به شماره غلط، یا کاندیدایی که مهارتش اشتباه ثبت شده و هیچوقت در جستجو پیدا نمیشود.
رزومه داده شخصی است
رزومه شماره تماس، سابقه کار و گاهی اطلاعات خانوادگی دارد. پیش از راه انداختن تحلیل خودکار این سؤالها را جواب بدهید:
- متن رزومه برای پردازش کجا میرود؟ روی سرور خودتان یا نزد ارائهدهنده مدل ابری؟
- چه کسانی در سازمان میتوانند رزومهها را ببینند؟
- رزومه کسانی که استخدام نشدند تا کی نگه داشته میشود؟
- آیا به متقاضی گفتهاید دادهاش چطور پردازش میشود؟
اگر داده باید داخل سازمان بماند، مدل و OCR را هم باید محلی اجرا کنید. ملاحظات فنی آن را در مقاله اجرای مدل زبانی روی سرور داخلی آوردهایم.
مهارتها و سابقه را چطور یکدست کنیم
استخراج درست هم همیشه داده مرتبی نمیدهد. یک نفر مینویسد «اکسل»، دیگری «Microsoft Excel» و سومی «کار با صفحه گسترده». برای انسان اینها یکی است، ولی برای جستجو و گزارش سه چیز متفاوتاند.
پس اگر میخواهید بعداً بپرسید «چند کاندیدا با این مهارت داریم؟» باید فکری برای یکدست کردن نام مهارتها بکنید. فهرست مهارت سازمان یا یک مدل شایستگی نقطه شروع خوبی است. جستجوی معنایی هم کمک میکند، چون به کلمه دقیق وابسته نیست. سالهای سابقه هم مسئله مشابهی دارد: ترکیب سال شمسی و میلادی یا همپوشانی دو شغل همزمان میتواند جمع ساده را خراب کند. این فیلد را هم در بازبینی نگاه کنید.
کیفیت سیستم را چطور بسنجید
پیش از اینکه به خروجی اعتماد کنید، آن را امتحان کنید. یک نمونه از رزومههای واقعی خودتان جدا کنید که همه نوع فایل در آن باشد: Word، PDF متنی، اسکن و عکس موبایل. بعد برای هر فیلد جداگانه نگاه کنید چند بار درست، چند بار خالی و چند بار غلط بوده است.
این سه حالت با هم فرق دارند. خالی بودن زحمت کمی برای کارشناس دارد. غلط بودن خطرناک است، چون ممکن است دیده نشود. سیستمی که بیشتر خالی میگذارد و کمتر غلط میسازد، معمولاً بهتر از سیستمی است که همه فیلدها را پر میکند. زمان بازبینی هر رزومه را هم یادداشت کنید. اگر بازبینی بهاندازه تایپ طول بکشد، چیزی به دست نیاوردهاید.
از تحلیل رزومه چه انتظاری نداشته باشید
- راستیآزمایی: سیستم میگوید چه چیزی نوشته شده، نه اینکه درست است یا نه.
- سنجش توانایی: سال سابقه و فهرست مهارت چیزی درباره کیفیت کار نمیگوید.
- معیار غیرشغلی: عکس، سن یا وضعیت خانوادگی نباید وارد سنجش شوند، حتی اگر در رزومه باشند.
پس خروجی این مرحله را ورودی تصمیم بدانید، نه خود تصمیم. کار اصلی تحلیل رزومه این است که وقت کارشناس را از تایپ به خواندن و فکر کردن منتقل کند. اگر این اتفاق بیفتد، حتی با چند خطای کوچک OCR هم برنده شدهاید.
نمونه عملی: تحلیل رزومه در Caren Enterprise AI
در ماژول استخدام Caren Enterprise AI، محصولی از کارن تکنولوژی، رزومه PDF، تصویر یا Word با دکمه «استخراج خودکار» تحلیل میشود. متن آن استخراج میشود و اسکنها با OCR فارسی و انگلیسی خوانده میشوند. بعد نام، نام خانوادگی، موبایل، ایمیل، خلاصه حرفهای، تا ۱۵ مهارت و سالهای سابقه استخراج و نرمال میشوند.
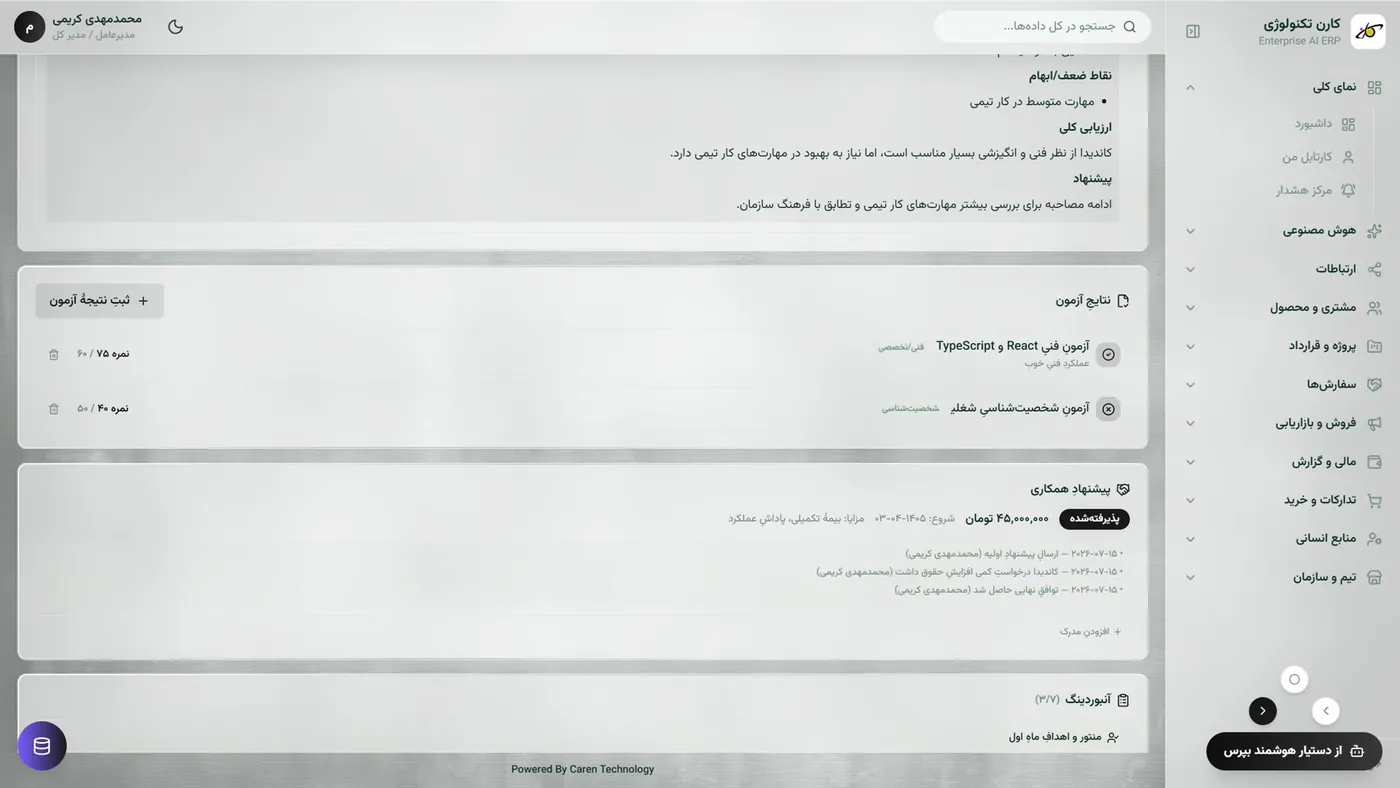
فرم پیشپر میشود و کاربر بازبینی و ذخیره میکند. هیچ ذخیره خودکاری در کار نیست و قاعده مدل هم این است: اگر در متن نبود، حدس نزن. رزومه تکراری با موبایل شناخته میشود.
در حالت ابری، OCR با مدل بینایی ابری انجام میشود و متن لازم به ارائهدهنده مدل میرود. در استقرار محلی، OCR با Tesseract و مدل زبانی روی سرور سازمان اجرا میشود. نگاه کلیتر به این حوزه در پلتفرم هوشمند منابع انسانی است.
میخواهید رزومههای واقعی را امتحان کنید؟
تحلیل رزومه در Caren Enterprise AI را در یک دموی زنده ببینید.
پرسشهای متداول
جستجوی کلمه کلیدی فقط متن یکسان را پیدا میکند. تحلیل با مدل زبانی معنا را میفهمد و فیلدهای مشخص را حتی در چیدمانهای متفاوت پیدا میکند و به داده مرتب تبدیل میکند.
عدد ثابتی نمیشود گفت، چون به کیفیت اسکن، فونت و چیدمان بستگی دارد. اسکن تمیز نتیجه خوبی میدهد و عکس کج یا کپی کمرنگ خطای بیشتری دارد. برای همین بازبینی نتیجه بخشی از فرایند است.
بله، به شرطی که نوشتهها خوانا باشند. نور یکنواخت، زاویه صاف و نبود سایه خیلی کمک میکند. اگر امکانش هست، از متقاضی فایل اصلی را بخواهید، چون متن مستقیم همیشه از OCR مطمئنتر است.
چون هم OCR و هم مدل زبانی ممکن است خطا کنند و مقدار غلط ظاهری کاملاً عادی دارد. یک بازبینی کوتاه روی فرم پیشپر از تماس با شماره اشتباه و پروندههای خراب جلوگیری میکند.
سیستم باید هر دو زبان را بخواند و OCR هم برای هر دو تنظیم شده باشد. در مرحله بازبینی به نامهای انگلیسی و ارقام توجه بیشتری کنید، چون جابهجایی جهت متن بیشتر همین بخشها را خراب میکند.
بهتر است همه به یک پرونده وصل شوند. شماره موبایل نشانه خوبی برای تشخیص فرد است، به شرطی که پیش از مقایسه نرمال شده باشد. اینطور سابقه نظرها و مصاحبههای قبلی هم از بین نمیرود.
این را خود سازمان باید با توجه به قواعد داخلی و الزامات حقوقیاش تعیین کند. مهم این است که مدت مشخص باشد، دسترسی محدود بماند و اگر میخواهید بعداً با متقاضی تماس بگیرید، از قبل به او گفته باشید.


