


گفتار فارسی آفلاین و صدای برند: وقتی متن نباید از سازمان خارج شود
متنی که به صدا تبدیل میشود گاهی نام مشتری، مبلغ بدهی یا اطلاعات کارکنان را در خود دارد. فرستادن این متن به یک سرویس بیرونی همیشه تصمیم درستی نیست. تبدیل متن به گفتار فارسی آفلاین این پردازش را به سرور خود سازمان میآورد. در این مقاله میخوانید این کار چطور انجام میشود، شبیهسازی صدای فارسی و ساخت صدای برند چه مراحلی دارد و چرا استفاده از صدای هر فرد فقط با اجازه صریح او مجاز است.
محصول آماده کارن تکنولوژی
این را روی داده واقعی کسبوکار خودتان ببینید
آنچه در این مقاله میخوانید، در محصولات کارن پیادهسازی شده است. در جلسه دمو، همان را روی داده و فرآیند خودتان اجرا میکنیم.
درخواست دمو رایگان یا تماس بگیرید: ۰۲۱-۸۸۶۱۴۲۸۲در این صفحه
چه متنی نباید بیرون برود
وقتی از یک سرویس ابری تبدیل متن به گفتار استفاده میکنید، متن به سرور آن سرویس میرود. برای یک تبلیغ عمومی، این کار معمولاً مشکلی ندارد. چند نوع متن اما حساسترند:
- پیامهای تلفنی به مشتری که نام، شماره حساب یا مبلغ دارند.
- اطلاعات پرونده بیماران یا مشتریان بیمه.
- اطلاعیههای داخلی درباره حقوق، جابهجایی یا تعدیل.
- خلاصههای صوتی از گزارش مدیریتی و قراردادها.
این تصمیم به طبقهبندی داده سازمان، قوانین حوزه کاری و قرارداد با سرویسدهنده بستگی دارد. قدم اول این است که بدانید چه متنی وارد این مسیر میشود. بعد میتوانید برای هر دسته تصمیم بگیرید. این همان منطقی است که در اجرای مدل زبانی روی سرور داخلی هم آمده است.
آفلاین دقیقاً یعنی چه
«آفلاین» یا «محلی» یعنی موتور و مدل روی سرور سازمان یا دستگاه کاربر اجرا میشوند و متن برای تبدیل به جای دیگری نمیرود. سه حالت را از هم جدا کنید:
| روش | متن کجا پردازش میشود | نکته |
|---|---|---|
| سرویس ابری | سرور سرویسدهنده | نگهداری ساده، به اینترنت وابسته |
| گفتار داخلی مرورگر | به مرورگر و سیستمعامل بستگی دارد | مسیر داده را برای هر مرورگر بررسی کنید |
| موتور محلی روی سرور سازمان | همان سرور | به سختافزار و نگهداری داخلی نیاز دارد |
به زنجیره کامل هم نگاه کنید. اگر گفتار با موتور محلی ساخته شود، ولی متن پیش از آن از یک مدل زبانی ابری بیاید، متن از سازمان خارج شده است. برای حساسترین دادهها، تمام مراحل را محلی کنید. دانلود اولیه مدلها هم معمولاً به اینترنت نیاز دارد، ولی این فقط یک بار و بدون متن شماست.
متن فارسی چطور به صدا تبدیل میشود
موتورهای گفتار معمولاً سه مرحله دارند. اول متن نرمال میشود. بعد به واج، یعنی صداهای زبان، تبدیل میشود. در آخر، مدل صوتی از روی واجها موج صدا میسازد.
فارسی در مرحله اول و دوم سختی خاصی دارد:
- مصوتهای کوتاه نوشته نمیشوند. «کرم» میتواند کِرم یا کَرَم باشد و موتور باید از جمله حدس بزند.
- کسره اضافه: در نوشتار دیده نمیشود، ولی بدون آن «مدیر فروش» طبیعی خوانده نمیشود.
- عدد و تاریخ: ۱۴۰۵ در تاریخ و در مبلغ یکسان خوانده نمیشود. شماره موبایل هم باید دستهدسته خوانده شود.
- حرفهای عربی: ی و ک عربی باید یکدست شوند.
برای همین نرمالسازی متن اهمیت زیادی دارد و بیشتر خطاهای شنیدنی از همانجا میآیند. مثال عملی این مشکل را در چرا هوش مصنوعی شماره تلفن فارسی را اشتباه میخواند ببینید.
چه زمانی محلی بودن نمیارزد
گفتار محلی رایگان به دست نمیآید. باید سرور و نگهداری داشته باشید و بهروزرسانی مدل هم با خودتان است. کیفیت طبیعی صدا هم در بعضی موتورهای سبک از سرویسهای ابری پایینتر است. پس اگر متن شما عمومی است و تیم فنی ندارید، سرویس ابری میتواند انتخاب بهتری باشد. برای مقایسه، چند متن واقعی خودتان را، با عدد و نام، به هر دو روش بسازید و به آنها گوش دهید.
راه میانه هم وجود دارد. متن عمومی مثل معرفی محصول میتواند از سرویس ابری بیاید و متن حاوی نام، شماره و مبلغ از موتور محلی. برای این کار قاعده مسیریابی روشنی لازم است تا کسی یا کدی متن حساس را اشتباهی به بیرون نفرستد. پیش از تصمیم، ظرفیت را هم آزمایش کنید. اگر قرار است در ساعت اوج چند پیام همزمان ساخته شود، زمان پاسخ سرور شما چقدر است؟ این پرسش برای تماس زنده مهم است، چون مکث طولانی به گفتگو آسیب میزند.
شبیهسازی صدا و آموزش مدل؛ دو راه متفاوت
شبیهسازی صدای فارسی یعنی ساختن گفتار تازه با ویژگیهای صدای یک فرد. دو راه برای این کار وجود دارد:
| شبیهسازی از نمونه کوتاه | آموزش مدل اختصاصی | |
|---|---|---|
| ورودی | یک نمونه صوتی کوتاه | دیتاست از صداهای تمیز همراه با متن |
| زمان آمادهسازی | کم | زیاد؛ به ضبط، بازبینی و آموزش نیاز دارد |
| سختافزار | کمتر از آموزش مدل | RAM زیاد و ترجیحاً GPU |
| کاربرد مناسب | آزمایش و نمونه اولیه | صدای ماندگار برند |
صدای برند یعنی صدای ثابتی که سازمان در تماس، راهنما و دستیار خود به کار میبرد. این صدا هم مثل لوگو بخشی از هویت است. برای ساخت آن، کیفیت دیتاست از هر چیز دیگری مهمتر است: صدای تمیز، بدون موسیقی و نویز، با برشهای کوتاه و متنی که واقعاً با صدا بخواند.
پیش از ضبط هم چند تصمیم باید گرفته شود. لحن این صدا چیست: رسمی، صمیمی یا میان این دو؟ آیا قرار است پیام بد هم با همین صدا گفته شود؟ اگر گوینده در دسترس نبود، جمله تازه چطور ساخته میشود؟ یک صدای برند باید سالها کار کند، پس این پرسشها از انتخاب موتور کمتر مهم نیستند.
اجازه صاحب صدا؛ شرط اول
این بخش از همه بخشهای فنی مهمتر است. صدای هر فرد بخشی از هویت اوست. فقط با اجازه صریح صاحب صدا از صدای او استفاده کنید. در دسترس بودن صدای او در یک ویدیو یا جلسه به معنی اجازه نیست.
یک اجازه درست این ویژگیها را دارد:
- مکتوب است. تأیید شفاهی در جلسه کافی نیست.
- دامنه دارد. روشن است صدا در چه کانالها، برای چه مدت و برای چه نوع پیامهایی استفاده میشود.
- قابل پس گرفتن است. روشن است اگر او از سازمان رفت یا نظرش عوض شد چه میشود و مدل و نمونهها چطور حذف میشوند.
- آزادانه است. کارمندی که برای حفظ شغل امضا میکند، واقعاً آزاد نیست. اگر نگرانی وجود دارد، یک گوینده حرفهای با قرارداد مشخص استخدام کنید.
الزامات قانونی را هم با مشاور حقوقی روشن کنید. این متن مشاوره حقوقی نیست و قواعد ممکن است در هر حوزه فرق داشته باشند.
همین قواعد درباره نمونههای ضبطشده هم صدق میکند. فایلهای دیتاست، مثل مدارک شخصی، باید دسترسی محدود و زمان حذف مشخص داشته باشند.
سوءاستفاده از شبیهسازی صدا یک خطر واقعی است
فناوریای که با یک نمونه کوتاه صدای کسی را میسازد، میتواند برای کلاهبرداری هم به کار برود. تماس با صدای جعلی مدیرعامل که از مسئول مالی انتقال وجه میخواهد، یک سناریوی شناختهشده است. پخش سخن ساختگی از قول یک فرد هم میتواند به او و سازمان آسیب بزند. این کنترلها را از اول بگذارید:
- دسترسی: فقط چند نفر مشخص حق ساخت گفتار با یک صدای شبیهسازیشده را داشته باشند.
- ثبت: هر تولید با کاربر، زمان و متن ثبت شود.
- فهرست مجاز: فقط صدای افرادی که اجازه دادهاند در سامانه باشد.
- اعلام: اگر مخاطب با صدای مصنوعی روبهروست، این را پنهان نکنید.
- تأیید چندمرحلهای: هیچ درخواست مالی یا حساس را فقط با شنیدن صدا تأیید نکنید و از یک کانال دوم تأیید بگیرید.
- نکته امنیتی: اگر جایی صدا را بهعنوان رمز عبور به کار میبرید، آن را بازبینی کنید. شبیهسازی صدا این روش را بهتنهایی ناکافی میکند.
نمونه عملی: Caren AI-OS
برای دیدن این گزینهها در یک محصول، پشته صوتی Caren AI-OS، محصولی از کارن تکنولوژی، را مثال میزنیم. جزئیات کامل در نیوشا و پشته صوتی آمده است. گفتار آفلاین با Piper (ONNX) کاملاً روی سرور سازمان اجرا میشود. نرمالسازی فارسی دارد، یعنی اعداد را به حروف تبدیل و ی و ک عربی را یکسان میکند. چند صدای فارسی و کنترل سرعت و مکث هم دارد. با Piper هیچ متنی از سازمان خارج نمیشود و فقط دانلود اولیه مدلها اینترنت میخواهد.
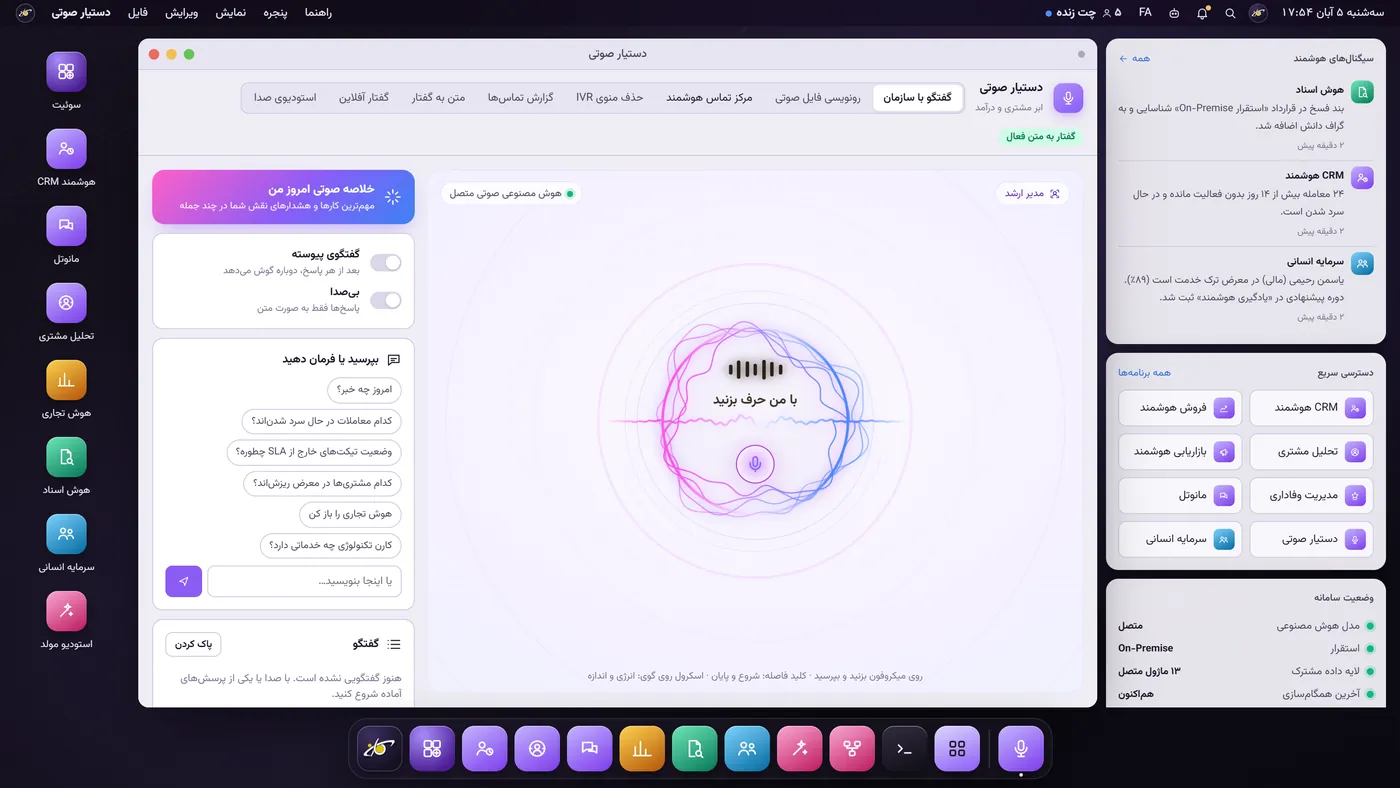
استودیوی صدا با ParsVoice-XTTS، بر پایه معماری Coqui XTTS-v2، روی سرور سازمان کار میکند. شبیهسازی از نمونه ۶ تا ۱۵ ثانیهای انجام میشود. برای آموزش مدل اختصاصی، دیتاست از فایلهای طولانی با faster-whisper با برش خودکار ۱ تا ۱۱ ثانیهای و بازبینی ساخته میشود، یا با ۶۰ جمله آماده ضبط میشود. این کار به RAM زیاد و ترجیحاً GPU نیاز دارد. آموزش روی سرور انجام میشود یا در دفترچه Colab. اگر داده باید داخل بماند، روی سرور خودتان آموزش دهید، چون Colab بیرون از سازمان است.
همه گزینههای صوتی محلی نیستند. تشخیص گفتار مرورگر و رونویسی فایل از سرویس گفتار مرورگر استفاده میکنند. توضیح بیشتر در معماری و امنیت و درباره پلتفرم صوتی در دستیار صوتی آمده است. فراموش نکنید که قواعد اجازه صاحب صدا را خود سازمان باید تعیین و اجرا کند. قیمت Caren AI-OS بسته به ابعاد سازمان، پلتفرمهای متصل و مدل استقرار تعیین میشود.
صدای برند را روی سرور خودتان بررسی کنید
در یک جلسه معرفی، گفتار آفلاین و استودیوی صدا را با متنهای نمونه شما مرور میکنیم.
پرسشهای متداول
به موتور، صدا و متن بستگی دارد. موتورهای سبک ممکن است طبیعی بودن کمتری داشته باشند، ولی برای پیامهای اطلاعرسانی اغلب کافیاند. بهجای مقایسه کلی، چند متن واقعی خودتان را با عدد و نام بسازید و همکاران گوش دهند و نظر بدهند.
فقط اگر اجازه مکتوب او این دوره را هم پوشش بدهد. بهتر است از همان ابتدا روشن باشد بعد از پایان همکاری چه اتفاقی برای صدا میافتد. اگر چنین بندی ندارید، از او اجازه بگیرید یا صدا را کنار بگذارید و مدل و نمونهها را حذف کنید.
بدون اجازه صریح و قرارداد مشخص با خود او، نه. این کار میتواند به معنی جعل هویت و گمراه کردن مخاطب باشد و تبعات حقوقی هم داشته باشد. حتی اگر «تقلید» نام بگذارید، باز هم مخاطب فکر میکند آن فرد پیام را تأیید کرده است.
تشخیص با گوش همیشه ممکن نیست و ابزارهای تشخیص هم خطا دارند. پس روی فرایند تکیه کنید: درخواست حساس را از کانال دوم تأیید کنید، پرسشی بپرسید که فقط خود فرد میداند و منبع فایل را بررسی کنید. در تصمیم مهم فقط به صدا اتکا نکنید.
شفافیت توصیه میشود، بهخصوص اگر صدا شبیه یک فرد واقعی باشد یا گفتگو تصمیمی به دنبال دارد. یک جمله کوتاه در شروع تماس کافی است. پنهان کردن آن اگر آشکار شود به اعتماد آسیب میزند. الزامات حوزه خودتان را هم بررسی کنید.
اتاق آرام، میکروفون ثابت و گویندهای با لحن یکنواخت. بهتر است همه ضبطها در یک محل و با یک تنظیم انجام شوند. پس از هر نوبت چند نمونه را گوش دهید. موسیقی زمینه، پژواک اتاق و صدای چند نفر همزمان، کیفیت مدل را پایین میآورند.
بله. متنباز بودن به معنی آزاد بودن هر نوع استفاده نیست. بعضی مدلها برای کاربرد تجاری شرط یا محدودیت دارند. پیش از استفاده در محصول یا تماس با مشتری، مجوز خود مدل، صداها و داده آموزش را جدا بررسی کنید.


